Un pedido aprobado que no actualiza el inventario hasta horas después, una alta de cliente que obliga a tres equipos a intervenir o un pago confirmado que bloquea procesos secundarios son síntomas de un problema de acoplamiento. La pregunta no es si la tecnología de eventos está de moda, sino cuándo adoptar arquitectura event driven para eliminar dependencias que ya perjudican a la operación.
Este modelo puede aportar capacidad de reacción, escalabilidad y mejor integración entre dominios de negocio. También puede multiplicar la complejidad si se introduce sin un caso de uso claro, sin gobierno de datos o sin capacidad operativa. La decisión debe apoyarse en el flujo de trabajo real, el coste de los fallos y el horizonte de modernización de la empresa.
Cuándo adoptar arquitectura event driven tiene sentido
Una arquitectura event driven resulta adecuada cuando los cambios relevantes del negocio deben provocar acciones en varios sistemas, pero no todos necesitan responder en el mismo instante ni dependen de una respuesta síncrona para completar su tarea.
Pensemos en una plataforma de comercio B2B. Al confirmarse un pedido, facturación debe crear el documento correspondiente, almacén debe preparar la expedición, analítica debe actualizar previsiones y atención al cliente puede enviar una notificación. Si el sistema de pedidos llama directamente a cada aplicación, cada integración aumenta la dependencia del núcleo comercial. Una caída temporal de un servicio periférico puede incluso impedir registrar la venta.
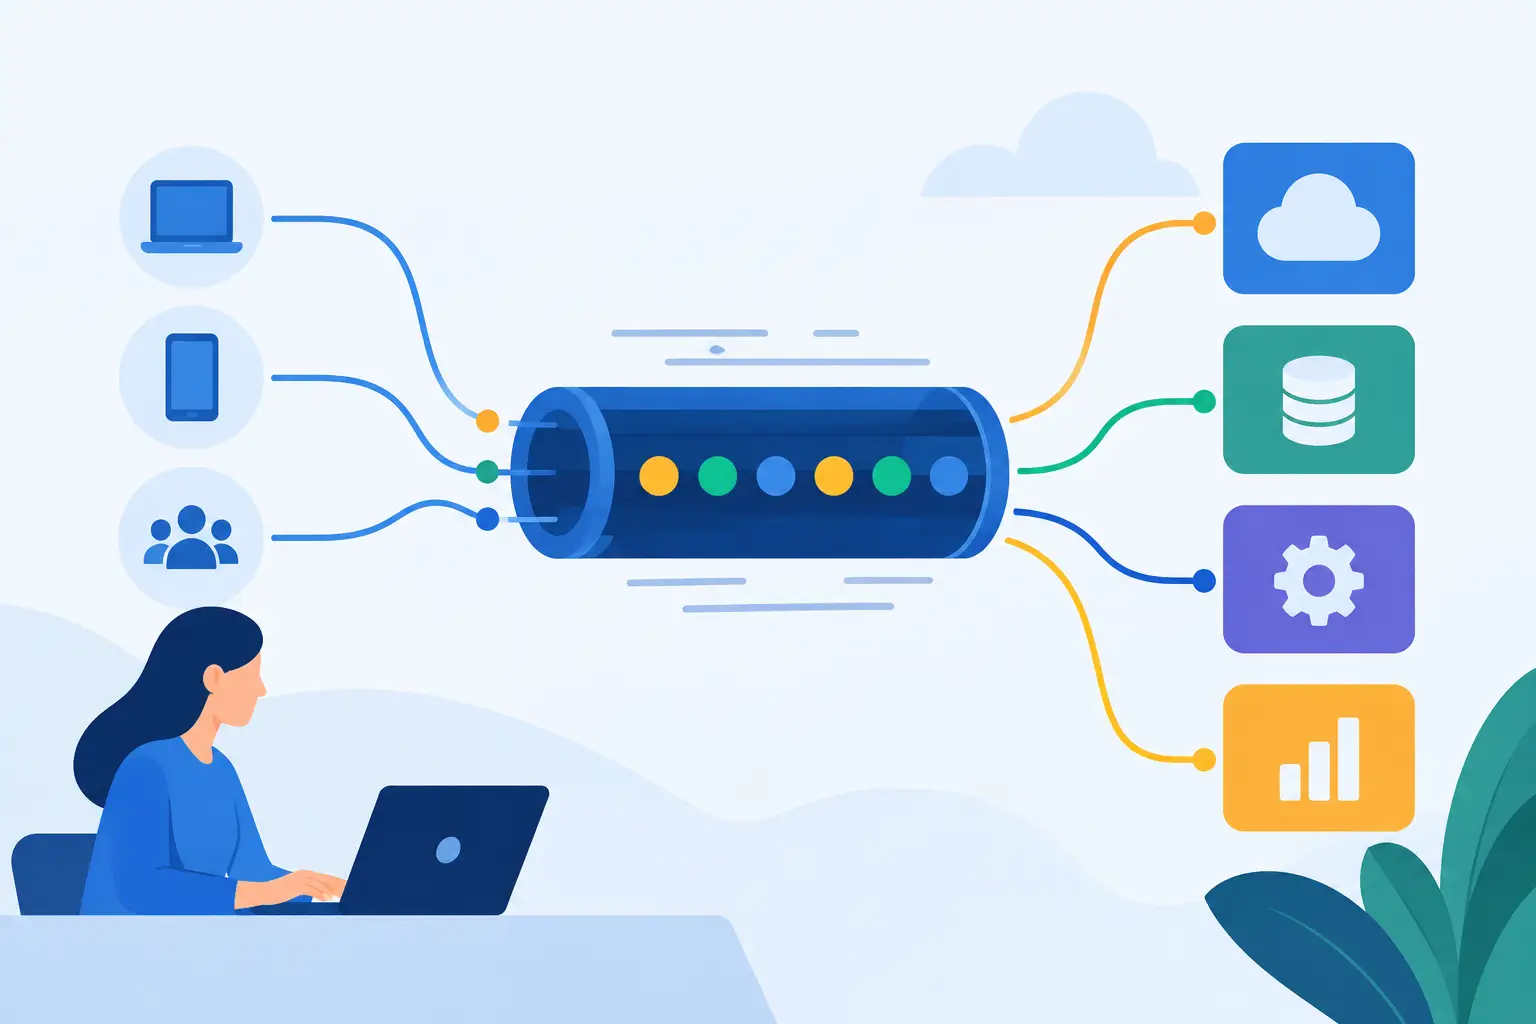
Con eventos, el sistema publica que el pedido ha sido confirmado. Los consumidores interesados procesan ese hecho según sus propias necesidades y ritmos. El emisor no necesita conocer la implementación, la disponibilidad ni la evolución interna de todos ellos.
La adopción está especialmente justificada cuando concurren varias de estas condiciones:
- Un mismo hecho de negocio activa procesos en tres o más aplicaciones o equipos.
- Los picos de carga son irregulares y los procesos posteriores pueden ejecutarse de forma asíncrona.
- La organización necesita desacoplar un sistema heredado sin sustituirlo de una sola vez.
- Los retrasos entre áreas generan errores manuales, pérdida de visibilidad o costes operativos medibles.
- Existen necesidades de auditoría, trazabilidad o reconstrucción de estados a partir de cambios relevantes.
Ninguna señal aislada obliga a cambiar la arquitectura. Un flujo con dos sistemas, bajo volumen y una dependencia síncrona legítima puede resolverse mejor mediante una API bien diseñada. El valor de los eventos aparece cuando reducen una complejidad que ya existe, no cuando añaden una capa técnica por anticipación.
Señales operativas que conviene medir antes de decidir
La conversación debe empezar fuera del diagrama de infraestructura. Conviene identificar qué procesos se retrasan, cuánto cuesta reconciliar datos y qué aplicaciones se convierten en cuellos de botella durante una incidencia.
Una señal habitual es la proliferación de integraciones punto a punto. El CRM llama al ERP, el ERP actualiza una aplicación de logística y esta alimenta una herramienta de informes. Cada cambio en un contrato obliga a coordinar despliegues, probar combinaciones y asumir riesgos de regresión. La arquitectura event driven puede sustituir parte de esa cadena por una distribución controlada de hechos de negocio.
Otra señal es la necesidad de procesar carga a distinta velocidad. Un sistema de captura de transacciones puede recibir miles de operaciones en pocos minutos, mientras que un motor de generación de informes puede procesarlas después. Separar ambas velocidades evita sobredimensionar componentes que no requieren respuesta inmediata y permite absorber picos con mayor previsibilidad.
También conviene valorar la autonomía de los equipos. Cuando diferentes dominios - ventas, operaciones, finanzas o soporte - evolucionan a ritmos distintos, una comunicación basada en eventos puede reducir la coordinación técnica necesaria. Sin embargo, autonomía no significa ausencia de reglas compartidas. Los nombres de los eventos, los datos que contienen y su ciclo de vida deben estar gobernados.
Lo que no resuelve una arquitectura basada en eventos
Los eventos no corrigen por sí solos datos maestros inconsistentes, procesos mal definidos ni responsabilidades de negocio ambiguas. Si cada departamento interpreta de manera distinta qué significa «cliente activo» o «pedido completado», distribuir esos conceptos solo propagará la inconsistencia con más rapidez.
Tampoco son la elección idónea para toda interacción. La consulta de un saldo actual, la validación de credenciales o la reserva de un recurso que requiere confirmación inmediata suelen necesitar comunicación síncrona. En estos casos, una API o una llamada directa puede ser más clara y fácil de operar.
El principal cambio mental es aceptar la consistencia eventual. Tras publicar un evento, algunos sistemas pueden tardar segundos o minutos en reflejar el nuevo estado. Esto es asumible para actualizar un cuadro de mando o enviar una comunicación, pero quizá no para autorizar un pago o liberar mercancía limitada. La tolerancia al desfase debe definirse con responsables de negocio, no deducirse únicamente desde ingeniería.
Diseñar eventos como contratos de negocio
Un error frecuente consiste en publicar eventos que reflejan tablas internas: `cliente_actualizado`, con decenas de campos de una base de datos, sin contexto sobre el cambio ocurrido. Ese enfoque expone detalles de implementación y convierte cualquier modificación de esquema en un riesgo para todos los consumidores.
Es preferible expresar hechos estables del dominio, como `pedido_confirmado`, `factura_emitida` o `envio_entregado`. Cada evento debe responder a una pregunta operativa concreta: qué sucedió, cuándo sucedió, qué entidad se ve afectada y qué información mínima necesita un consumidor para actuar.
La evolución de contratos merece el mismo rigor que una API pública. Añadir campos suele ser menos problemático que eliminar o cambiar su significado, pero ambas decisiones deben versionarse y comunicarse. Un catálogo de eventos, propietarios funcionales y criterios de compatibilidad evitan que el bus de eventos se convierta en una dependencia opaca.
Idempotencia, reintentos y errores esperables
En sistemas distribuidos, un consumidor puede recibir el mismo mensaje más de una vez. También puede fallar después de ejecutar una parte de su trabajo. Por eso, los procesos deben ser idempotentes: procesar un evento repetido no debe duplicar una factura, una reserva ni un correo.
Los reintentos requieren límites, observabilidad y rutas para mensajes que no pueden procesarse. No basta con almacenar fallos en una cola apartada. Debe existir una responsabilidad clara para investigarlos, corregir datos cuando proceda y reintroducir el trabajo de forma segura. La operación diaria determina el éxito de la arquitectura tanto como la elección de plataforma.
Trazabilidad de extremo a extremo
Cuando una transacción atraviesa varios consumidores, el equipo necesita responder rápidamente a preguntas sencillas: qué ocurrió con este pedido, qué servicio lo procesó y dónde se produjo el retraso. Para ello, los eventos deben incluir identificadores de correlación, y las métricas deben mostrar latencia, volumen, errores y antigüedad de los mensajes pendientes.
Esta visibilidad tiene un impacto directo en negocio. Reduce el tiempo de diagnóstico durante incidencias, permite identificar acuerdos de nivel de servicio incumplidos y evita que la reconciliación dependa de hojas de cálculo o consultas manuales.
Una ruta de adopción con riesgo controlado
La modernización rara vez exige transformar toda la organización de una vez. El enfoque más prudente consiste en seleccionar un flujo acotado, frecuente y con un coste de fallo conocido. Por ejemplo, la propagación de pedidos confirmados desde un sistema comercial a facturación y logística.
Primero, se debe establecer el evento canónico y los resultados que se esperan: menos intervenciones manuales, menor tiempo de actualización o reducción de errores de conciliación. Después, se incorpora un consumidor cada vez, manteniendo mecanismos de comparación con el proceso actual durante un periodo limitado. Esta fase permite validar la calidad de datos, el comportamiento ante reintentos y la carga real.
La elección de tecnología debe llegar después de definir el patrón operativo. Un broker, una plataforma de streaming o una cola gestionada responden a necesidades distintas de retención, orden, volumen, coste y experiencia interna. Adoptar una herramienta potente sin capacidad para administrarla, monitorizarla y asegurarla puede trasladar el problema a otra capa.
También es recomendable fijar desde el principio quién posee cada evento, quién aprueba cambios de contrato y qué equipos atienden las incidencias. La arquitectura distribuida sin un modelo de responsabilidad distribuido crea zonas grises precisamente cuando más presión existe.
La decisión correcta parte del proceso, no del patrón
Adoptar eventos merece la pena cuando la empresa necesita que los hechos de negocio circulen con fiabilidad entre sistemas que deben evolucionar de forma independiente. Merece menos la pena cuando se utiliza para disimular una lógica de negocio confusa o para evitar una conversación necesaria sobre datos, propiedad y operación.
El mejor punto de partida es un flujo con impacto medible, límites claros y patrocinio tanto técnico como operativo. Si ese primer caso reduce fricción real sin perder control, la arquitectura tendrá una base sólida para crecer donde aporte valor.