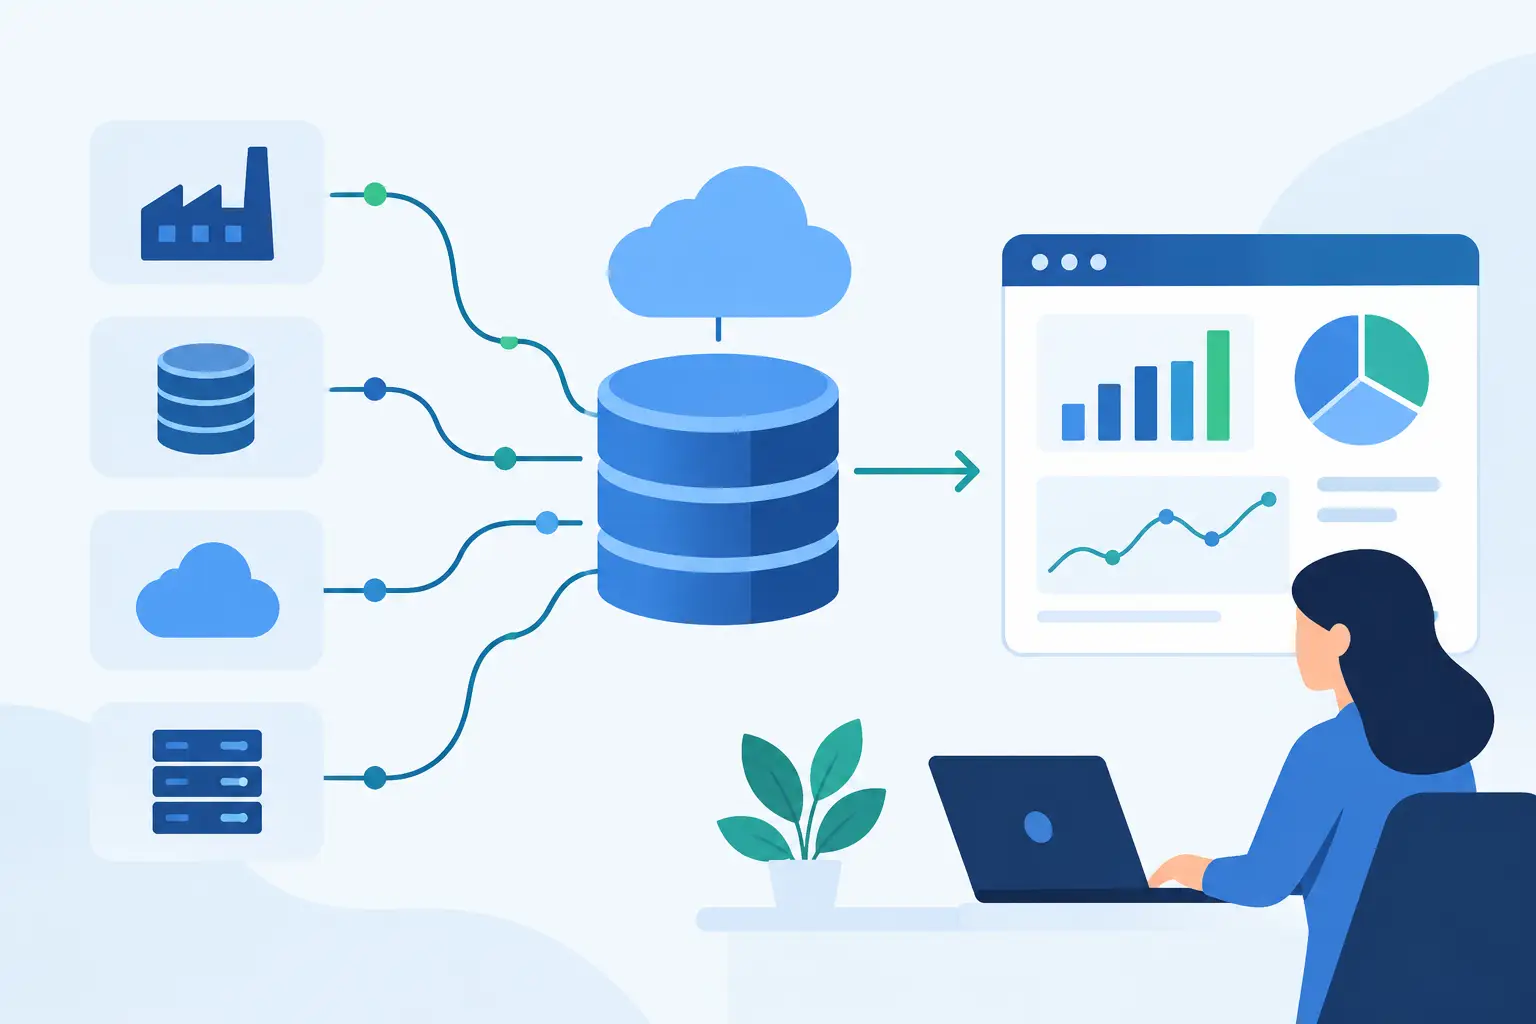
Cuando operaciones trabaja en un ERP, ventas en un CRM, almacén en una aplicación propia y finanzas en hojas de cálculo, el problema no es solo la falta de visibilidad. También aparecen decisiones tardías, conciliaciones manuales, errores de inventario y procesos difíciles de escalar. Esta guía de integración de datos operativos explica cómo abordar ese problema con criterio arquitectónico y sin convertir la integración en otro sistema frágil que mantener.
El objetivo no consiste en mover datos de una plataforma a otra porque sea técnicamente posible. Consiste en conseguir que cada área disponga de información fiable, con la latencia adecuada y un significado compartido, para ejecutar mejor sus procesos. Eso exige combinar diseño de datos, prioridades de negocio, seguridad y una disciplina clara de operación.
Qué debe resolver una integración de datos operativos
Los datos operativos describen lo que está ocurriendo en la empresa: pedidos, niveles de existencias, incidencias, envíos, facturas, clientes, estados de producción o tiempos de atención. A diferencia de los datos puramente analíticos, suelen intervenir directamente en la ejecución diaria. Un dato duplicado o desactualizado puede bloquear un pedido, generar una factura incorrecta o llevar a un equipo a actuar sobre una información equivocada.
Por eso, una integración bien planteada debe resolver cuatro cuestiones. Primero, qué sistema es la fuente de verdad de cada entidad. Segundo, qué datos deben circular y con qué frecuencia. Tercero, cómo se transforman sin perder trazabilidad. Cuarto, qué ocurre cuando un sistema no responde, un dato no valida o un proceso debe repetirse.
La respuesta no siempre es sincronización en tiempo real. Para la actualización de stock crítico o el estado de un pedido, unos minutos pueden ser excesivos. Para la consolidación financiera o determinados informes internos, una carga nocturna puede ser suficiente y mucho más económica de operar. La arquitectura debe responder al impacto del retraso, no a una preferencia tecnológica.
Empiece por el proceso, no por la herramienta
El error habitual es seleccionar una plataforma de integración antes de definir el flujo operativo que debe mejorar. Las herramientas pueden acelerar la entrega, pero no corrigen reglas de negocio ambiguas ni resuelven una propiedad de datos mal asignada.
El primer trabajo consiste en mapear un proceso completo, desde el evento que lo inicia hasta el resultado esperado. Por ejemplo, en un flujo de pedido a cobro conviene identificar cuándo se crea el pedido, quién valida el crédito, dónde se reserva el inventario, qué sistema emite la factura y qué estado ve el cliente. Este ejercicio revela duplicidades, pasos manuales y dependencias que rara vez aparecen en un diagrama de sistemas de alto nivel.
Después, clasifique las integraciones por valor y riesgo. Un flujo que evita errores de facturación o reduce cancelaciones tiene normalmente más prioridad que una sincronización orientada a comodidad administrativa. También debe distinguir entre integraciones de lectura, que exponen datos para consulta, e integraciones de escritura, que modifican sistemas de registro y requieren controles más estrictos.
Defina propietarios y fuentes de verdad
Cada entidad clave necesita un propietario explícito. El CRM puede ser la fuente de verdad para los datos comerciales del cliente, mientras que el ERP lo es para condiciones de pago y facturación. Si dos sistemas pueden modificar el mismo campo sin una regla de precedencia, la integración acabará propagando conflictos.
No basta con documentarlo en una presentación. Las reglas deben materializarse en contratos de interfaz, validaciones y permisos. Si el ERP rechaza una dirección por formato, el CRM no debería marcar la sincronización como completada. Debe existir un estado de error visible, un responsable y un procedimiento de corrección.
Elija un patrón de integración adecuado
No hay una única arquitectura correcta. La elección depende del número de sistemas, el volumen, la criticidad de los flujos, las capacidades de las aplicaciones existentes y la madurez operativa del equipo.
Las integraciones punto a punto pueden ser razonables para pocos sistemas y procesos acotados. Son rápidas de implantar, pero su coste crece de forma no lineal: cada nuevo sistema añade conexiones, transformaciones y casos de error. En entornos con varias aplicaciones críticas, conviene introducir una capa de integración que centralice autenticación, transformación, monitorización y políticas de acceso.
Las API son apropiadas para consultas y operaciones transaccionales con respuesta inmediata. Los eventos resultan preferibles cuando varios consumidores deben reaccionar a un cambio, como la creación de un pedido o la actualización de un envío. Los procesos por lotes siguen siendo útiles para grandes volúmenes, sistemas heredados o tareas cuya ventana de actualización es amplia.
Un patrón frecuente y sólido combina los tres enfoques. Una API permite consultar el estado de un pedido, un evento comunica que el pedido ha cambiado y una carga por lotes reconcilia información histórica o corrige desviaciones. Intentar imponer tiempo real a todos los datos suele elevar costes y complejidad sin aportar valor equivalente.
Diseñe la integración para fallar de forma controlada
En producción, los fallos no son una excepción. Las API aplican límites de uso, las redes tienen interrupciones, los proveedores cambian formatos y los sistemas heredados pueden devolver respuestas incompletas. Una integración madura asume esta realidad desde el diseño.
La idempotencia es esencial en operaciones que pueden reintentarse. Si un mensaje se entrega dos veces, el sistema receptor no debe crear dos pedidos ni emitir dos facturas. También son necesarios reintentos con espera progresiva, colas para desacoplar sistemas y mecanismos de compensación cuando una transacción distribuida no puede completarse.
La observabilidad debe formar parte del alcance inicial. Cada flujo necesita identificadores de correlación, registros estructurados y métricas que permitan responder preguntas concretas: qué mensajes han fallado, dónde se han detenido, cuánto tardan y cuántos se han procesado correctamente. Un panel con indicadores generales no sustituye la capacidad de seguir un pedido concreto entre sistemas.
Mantenga los errores fuera de la sombra
Los registros de error no son una solución operativa si nadie los revisa. Establezca alertas según criticidad y un circuito de gestión para incidencias repetibles. Algunas pueden corregirse automáticamente, como un error temporal de conexión. Otras requieren intervención funcional, como un código de producto inexistente o un cliente bloqueado por crédito.
Conviene separar los errores técnicos de los errores de calidad de datos. El primero suele corresponder a tecnología; el segundo, a menudo, a un propietario de proceso. Mezclarlos en la misma cola ralentiza la resolución y diluye responsabilidades.
Gobierno y seguridad: requisitos de diseño
Integrar datos operativos amplía la superficie de riesgo. Las credenciales compartidas, los permisos excesivos y las copias no controladas de información sensible pueden convertir una mejora de eficiencia en un problema de cumplimiento y seguridad.
Aplique el principio de mínimo privilegio: cada integración debe acceder solo a los datos y acciones que necesita. Utilice identidades de servicio diferenciadas, gestione secretos fuera del código y registre las operaciones de escritura relevantes. Cuando haya datos personales, financieros o sujetos a regulación sectorial, defina además políticas de retención, enmascaramiento y acceso por rol.
El gobierno no debe bloquear el avance con comités interminables. Su función es establecer decisiones repetibles: nomenclatura, versiones de interfaces, propietarios de datos, criterios de calidad y proceso de aprobación para cambios. Sin estas reglas, cada nueva integración introduce excepciones que elevan el coste de mantenimiento.
Una hoja de ruta realista para ejecutar
La implementación debe empezar con un flujo de alto valor y alcance controlado. Un primer caso bien seleccionado demuestra el modelo de trabajo, valida las decisiones técnicas y permite medir resultados antes de extender la plataforma. La condición es que no sea un prototipo aislado: debe usar desde el principio los estándares de seguridad, monitorización y despliegue que se aplicarán después.
En la fase de descubrimiento, documente sistemas, responsables, interfaces disponibles, calidad de datos, volúmenes y restricciones de negocio. Después defina el contrato de datos, los escenarios de excepción y los criterios de aceptación. Las pruebas deben incluir no solo el camino correcto, sino duplicados, caídas, reintentos, datos incompletos y cambios de versión.
El despliegue requiere una estrategia de transición. En algunos casos bastará con una activación gradual; en otros, será necesario operar en paralelo y reconciliar resultados antes de retirar el proceso anterior. La decisión depende del coste de un error y de la posibilidad de revertir cambios sin perder información.
StrateCode aborda este tipo de iniciativas uniendo diagnóstico de procesos, arquitectura y ejecución técnica. Esa combinación reduce la distancia habitual entre una recomendación estratégica y un sistema operable, con responsables claros y métricas verificables.
Cómo medir si la integración está funcionando
El éxito no se mide por el número de conectores desplegados. Debe medirse por resultados operativos: reducción de conciliaciones manuales, menor tiempo de ciclo, menos errores de pedido, mejora de la disponibilidad de información o disminución de incidencias de soporte.
Añada indicadores técnicos que expliquen esos resultados, como latencia, tasa de errores, mensajes en cola, porcentaje de reintentos y tiempo medio de recuperación. Si una integración cumple su acuerdo de servicio pero genera excepciones funcionales recurrentes, no está cumpliendo su propósito de negocio.
Una integración de datos operativos bien diseñada se vuelve casi invisible para los usuarios: el pedido llega donde debe, el inventario refleja la realidad y los equipos dejan de perseguir versiones contradictorias de la misma información. Alcanzar ese estado exige arquitectura y disciplina, pero también la decisión de tratar los datos como parte central de la operación, no como un subproducto de las aplicaciones.